AI 데이터센터의 진정한 주인공은 이제 GPU가 아니다: ‘빛의 연결’이 바꿀 미래의 5가지 신호
안녕하세요. 코드폴릭스 입니다. 네이버도 이제 데이터센터 기업으로 변화하고자 하는데, 사실 AI 데이터센터의 미래는 GPU의 성능이 아니라 데이터 이동 효율에 달려 있습니다. 이번 글에서는 CPO, 전력 효율화, 광 인터커넥트 등 변화의 신호를 살펴봅니다.
1. 도입부: ‘연산’의 시대에서 ‘연결’의 시대로
지금까지 AI 산업의 주인공은 단연 GPU였습니다. “더 강력한 칩이 더 똑똑한 AI를 만든다”는 명제 아래, 엔비디아의 최신 가속기를 얼마나 확보하느냐가 기업의 경쟁력이었죠. 하지만 이제 우리는 개별 칩의 연산 성능보다 수만 개의 GPU를 하나로 묶는 ‘인터커넥트(Interconnect)’ 가 시스템 전체의 병목(Bottleneck)이 되는 시점에 서 있습니다.
이제 AI 인프라는 단순히 칩의 집합체가 아닙니다. 소스 컨텍스트가 시사하듯, 최신 AI 랙 하나는 과거의 데이터센터 전체에 맞먹는 컴퓨팅 단위를 형성하고 있습니다. 아무리 강력한 GPU라도 데이터를 제때 공급받지 못하거나 노드 간 동기화가 지연되면 그 성능은 반감됩니다. AI 인프라의 진정한 경쟁력이 ‘연산 자원’ 그 자체에서, 그 자원들을 하나의 거대한 유기체로 숨 쉬게 하는 ‘데이터 이동 효율’로 확장되고 있는 이유입니다.
2. [Takeaway 1] 구리의 한계: “구리를 쓸 수 있다면 구리를 써라, 하지만…”
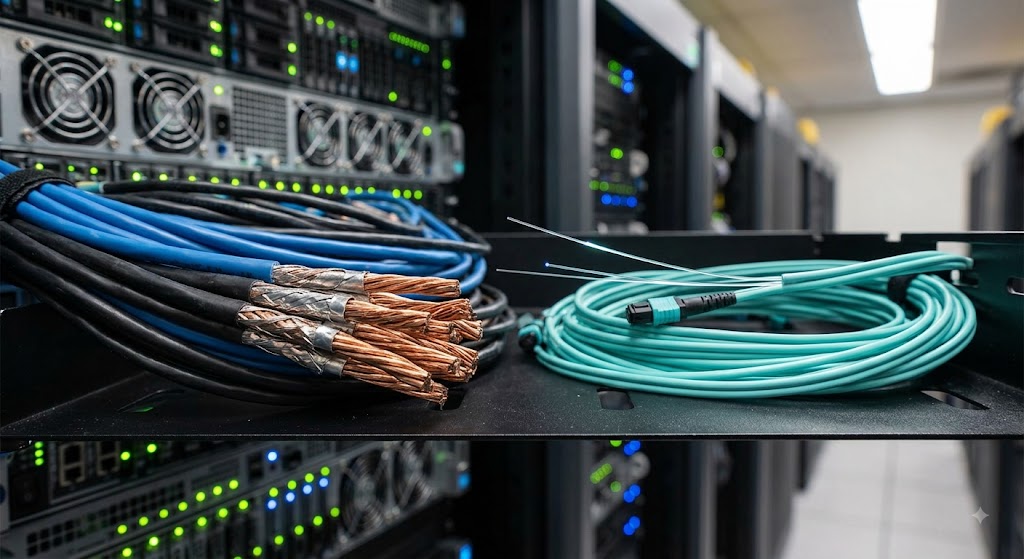
데이터센터 내부 연결의 표준이었던 구리 기반 전기 신호 전송은 이제 물리적 임계점에 도달했습니다. 전송 속도가 800G를 넘어 1.6T 시대로 접어들면서 구리는 구조적 한계에 부딪혔죠.
“구리를 사용할 수 있다면 구리를 사용하십시오. 구리는 전력 소모가 없고 수동적이며 신뢰성이 높기 때문입니다. 하지만 속도가 계속 높아지면 구리의 도달 거리는 점점 더 짧아질 수밖에 없습니다.” — 엔비디아 길라드 샤이너(Gilad Shainer) SVP, GTC 2026에서
전기 신호는 속도(주파수)가 올라갈수록 감쇠와 발열이 기하급수적으로 증가합니다. 특히 데이터를 직렬화하여 고속으로 쏘아 올리는 SerDes(직병렬 변환기) 속도가 향상됨에 따라 구리 케이블이 신호를 온전히 전달할 수 있는 거리는 치명적으로 짧아지고 있습니다. 엔비디아가 ‘베라 루빈(Vera Rubin)’을 넘어 ‘파인만(Feynman)’ 아키텍처로 이어지는 미래 로드맵에서 광 인터커넥트(Optical Interconnect)로의 네이티브 전환을 예고한 것은, 더 이상 구리만으로는 100만 개 GPU 클러스터를 지탱할 수 없다는 물리적 선언과 같습니다.
3. [Takeaway 2] CPO(공동 패키징 광학): 단순한 부품이 아닌 ‘패키징의 혁명’
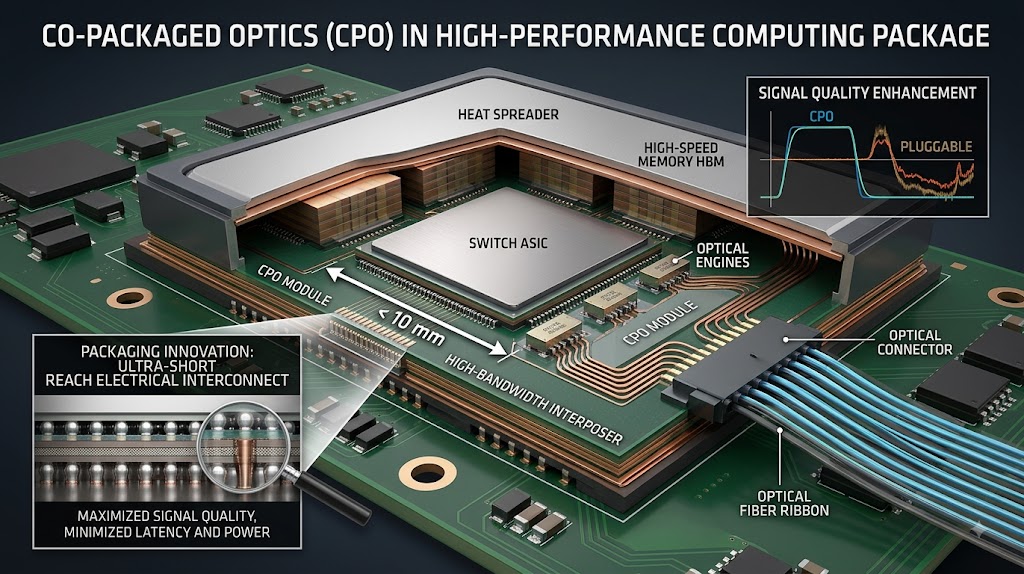
최근 시장의 가장 뜨거운 화두인 CPO(Co-Packaged Optics, 공동 패키징 광학)는 단순한 광모듈 제품이 아닙니다. 이는 광 엔진을 칩 패키지 바로 위에 탑재하는 ‘구조적 진화’이자 패키징의 혁명입니다.
기존의 플러거블(Pluggable) 방식은 전기 신호가 칩을 떠나 PCB 트레이스를 길게 지나가야 했습니다. 이 과정에서 신호 왜곡이 발생했고, 이를 보정하기 위해 전력을 많이 소비하는 DSP(신호처리장치)가 필수적이었죠. 하지만 CPO 구조에서는 광 엔진이 칩 바로 옆 ’10mm 이내’에 배치됩니다.
- 신호 품질의 비약적 향상: 이동 거리가 극단적으로 짧아지면 신호 왜곡이 최소화됩니다.
- DSP 제거 효과: 신호 품질이 확보됨에 따라 전력 소비의 주범이었던 DSP를 제거하거나 기능을 대폭 축소할 수 있습니다.
- 물리적 한계 극복: PCB 트레이스 손실을 원천 차단함으로써 더 높은 대역폭을 더 작은 면적에 구현합니다.
4. [Takeaway 3] 하이퍼스케일러의 절박함: 전력 효율이 곧 생존이다
구글, 메타, 마이크로소프트와 같은 하이퍼스케일러들이 CPO 도입에 사활을 거는 이유는 명확합니다. 2026년 이들의 CAPEX(설비투자)가 6,000억 달러에 달할 것으로 예상되는 상황에서, 운영 비용의 핵심인 전력 효율은 단순한 환경 보호가 아닌 기업의 수익 구조를 결정짓는 ‘생존 변수’가 되고 있습니다.
CPO 기술이 가져다주는 경제적 이점은 압도적입니다. 소스에 따르면:
- 트랜시버 단위: 기존 800G DSP 기반 모듈 대비 약 65~73%의 전력 절감이 가능합니다.
- 네트워크 전체: 계층 구조의 단순화(3단계 → 2단계)까지 더해지면 전체 네트워크 전력을 약 48%까지 절감할 수 있습니다.
수십만 개의 GPU가 돌아가는 클러스터에서 수 퍼센트의 전력 절감은 곧 수십 메가와트의 전기료 차이이며, 제한된 전력 인프라 내에서 더 많은 AI 연산 자원을 투입할 수 있는 ‘기회 자본’이 됩니다.
5. [Takeaway 4] 세 가지 확장성: Scale-Up, Out, Across의 조화
현대 AI 데이터센터는 세 가지 층위의 유기적인 연결을 통해 비로소 하나의 ‘AI 팩토리’로 완성됩니다.
- Scale-Up (랙 내부): NVLink를 통해 수십, 수백 개의 GPU를 연결합니다. 엔비디아의 Vera Rubin NVL576 및 NVL1152는 이제 랙 전체를 하나의 컴퓨팅 단위로 묶어 초고대역폭(3.6TB/s급)을 구현합니다.
- Scale-Out (랙 간): 수천 개의 노드를 클러스터로 묶는 주무대입니다. 광 인터커넥트가 전기 신호의 거리 한계를 극복하며 클러스터의 물리적 규모를 확장합니다.
- Scale-Across (데이터센터 간): 전력과 공간의 한계로 인해 지리적으로 떨어진 데이터센터들을 하나로 묶는 단계입니다. 여기에는 빛의 위상(Phase)과 진폭을 조절해 장거리 손실을 극복하는 코히런트(Coherent) 광학과 DWDM(고밀도 파장 분할 다중화) 기술이 사용됩니다. 이는 마치 옆방에 있는 데이터센터와 통신하는 듯한 ‘물리적 거리의 소멸’을 구현합니다.
6. [Takeaway 5] 밸류체인의 지각변동: 제조 플랫폼의 내재화
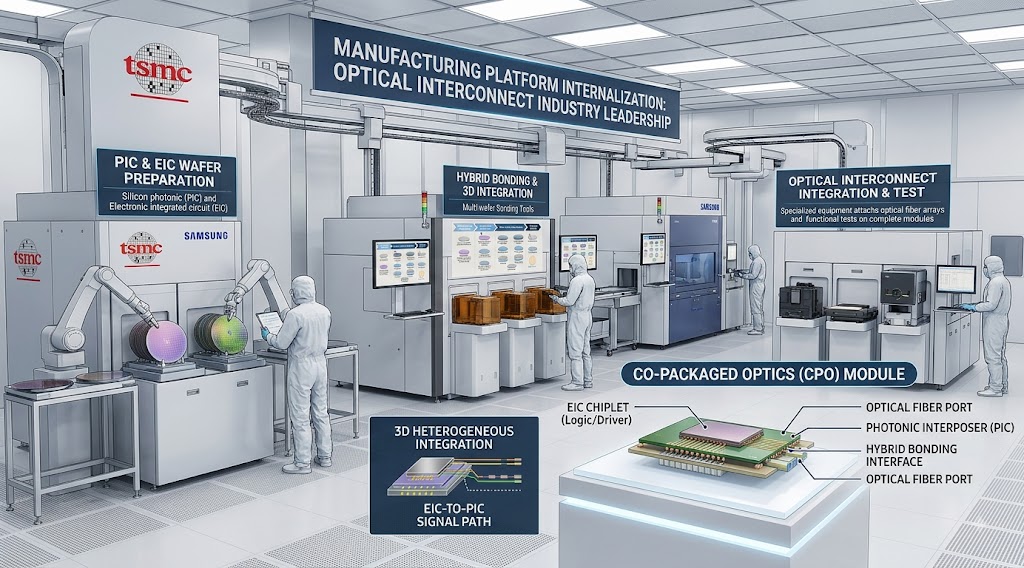
광 인터커넥트 산업의 부가가치는 이제 단순 부품 조립에서 ‘제조 플랫폼의 내재화’로 이동하고 있습니다. 과거 파편화되었던 광부품들이 이제는 첨단 반도체 파운드리의 공정 안으로 흡수되고 있습니다.
- TSMC의 COUPE: CoWoS 패키징을 기반으로 EIC(전자회로)와 PIC(광회로)를 하이브리드 본딩하는 완전한 제조 플랫폼을 제시하며 시장을 선도하고 있습니다.
- 삼성전자의 턴키 전략: 메모리(HBM), 로직, 패키징을 통합 제안하며 2027년 핵심 통합 기술 완성을 목표로 추격을 가속화하고 있습니다.
- OSAT의 진화: ASE와 같은 후공정 업체들은 마이크론 이하 단위의 정밀한 광학 정렬 기술을 바탕으로 CPO 아키텍처 구현의 필수 파트너로 부상했습니다.
이는 더 이상 광통신이 별도의 영역이 아니라, 반도체 제조 및 패키징 패권의 일부가 되었음을 시사합니다.
결론: 다음 병목을 넘어 ‘AI 팩토리’의 시대로
광 인터커넥트는 이제 단순한 통신 기술이 아닙니다. AI 인프라라는 거대한 유기체의 정보를 실어 나르는 ‘신경망’ 그 자체입니다. 우리는 이제 GPU의 연산 속도를 걱정하는 시대를 지나, 그 연산의 결과물을 얼마나 빛의 속도로 막힘없이 흐르게 할 것인가를 고민하는 시대에 서 있습니다.
데이터가 물리적 장벽 없이 빛의 속도로 흐르는 시대에, 우리가 상상할 수 있는 AI 모델의 규모는 어디까지일까요? 연결의 한계가 사라진 지금, AI 데이터센터는 거대한 연산 공장을 넘어 인류의 지능을 무한히 확장하는 진정한 ‘AI 팩토리’로 거듭나고 있습니다.
그렇다면 이 광통신시대에 떠오르는 기업들은 어디가 있을까요? 저는 아래 3개의 기업을 눈여겨 봐야 한다고 생각하고 있습니다.
1. 코닝(GLW)
2. 코히어런트(COHR)
3. 루멘텀(LITE)
본 콘텐츠는 투자 권유가 아닌 정보 제공 목적으로 작성되었습니다. 투자의 최종 결정은 독자 본인의 판단과 책임 하에 이루어져야 합니다.